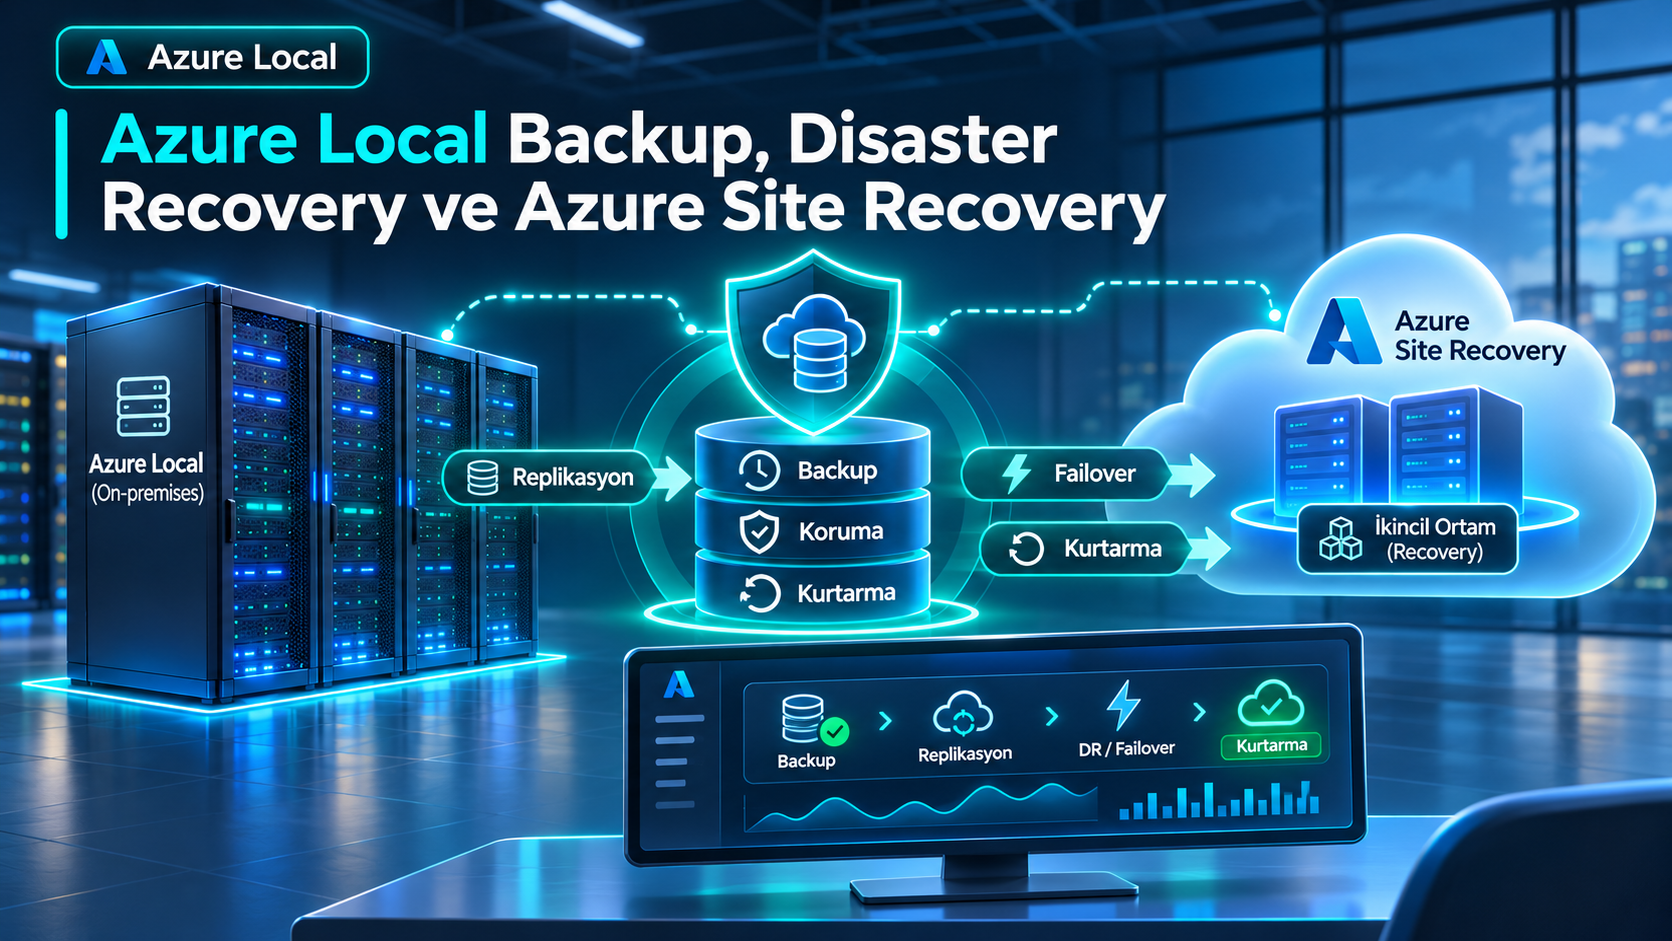
Azure Local projelerinde sanal makineleri yeni platforma taşıdıktan sonra en fazla önem verdiğim konulardan birisi backup ve disaster recovery mimarisi. Malum, sanallaştırma altyapısını kurmak, network ve storage yapılandırmasını tamamlamak, ardından sanal makineleri çalıştırmak projenin önemli bir bölümü ancak işin operasyon tarafında en kritik konulardan birisi bu sistemlerin herhangi bir problem durumunda nasıl kurtarılacağı. Özellikle müşterinin mevcut VMware veya Hyper-V ortamından Azure Local’a geçtiği projelerde backup altyapısının da yeniden değerlendirilmesi gerekiyor. Çünkü mevcut sanallaştırma platformunda yıllardır kullandığınız backup ürününün Azure Local üzerindeki yeni VM yönetim modelini aynı şekilde desteklediğini varsaymak doğru değil.
Örneğin dört node’lu bir Azure Local cluster kurduğumuzu düşünelim. Storage Spaces Direct sayesinde verilerimiz birden fazla fiziksel disk ve node üzerinde korunuyor, herhangi bir node arızalandığında sanal makinelerimiz uygun kapasite ve cluster koşulları sağlandığında diğer node’larda çalışmaya devam edebiliyor. Bu mimari bize yüksek erişilebilirlik sağlıyor ancak backup veya disaster recovery ihtiyacını ortadan kaldırmıyor. Bir kullanıcı yanlışlıkla kritik verileri silerse, uygulama üzerinde mantıksal veri bozulması oluşursa veya ransomware saldırısı sonucunda sanal makinelerimizin içerisindeki veriler şifrelenirse cluster’ın sağlıklı olması bizi kurtarmayacaktır. Çünkü storage resiliency ile veri kurtarma aynı şey değil.
Benzer şekilde bütün node’ların aynı veri merkezinde bulunduğu bir ortamda elektrik, yangın, su baskını veya daha büyük bir fiziksel problem yaşandığında cluster içerisindeki disklerin birbirini korumasının bir anlamı kalmayabilir. Bu nedenle Azure Local üzerinde backup, high availability ve disaster recovery kavramlarını ayrı ayrı değerlendirmek gerekiyor. Backup geçmişteki belirli bir veri veya sistem durumuna geri dönebilmemizi sağlarken, high availability belirli donanım veya servis arızalarında hizmetin devam etmesini hedefliyor. Disaster recovery ise birincil ortamın kullanılamadığı durumlarda uygulamaları başka bir lokasyonda veya Azure üzerinde yeniden çalıştırabilmemizi sağlıyor.
Bence burada ilk yapılması gereken iş ürün seçmek değil, kurumun kurtarma beklentisini belirlemek. Çünkü her uygulama için aynı koruma modelini kullanmak hem maliyetli hem de gereksiz olabilir. Örneğin bir dosya sunucusunda dört saatlik veri kaybı kabul edilebilirken, yoğun işlem yapan bir ERP veritabanında birkaç dakikalık veri kaybı bile ciddi problem oluşturabilir. Benzer şekilde bir test sunucusunun ertesi gün açılması yeterli olabilirken, üretim uygulamasının mümkün olduğunca kısa sürede tekrar hizmet vermesi beklenebilir.
Bu noktada RPO ve RTO kavramlarını doğru tanımlamamız gerekiyor. Recovery Point Objective, yani RPO, bir felaket sonrasında kabul edilebilir maksimum veri kaybını ifade ediyor. Recovery Time Objective, yani RTO ise hizmetin ne kadar sürede yeniden çalışır hale gelmesi gerektiğini belirliyor. Örneğin RPO değeri 15 dakika, RTO değeri iki saat olarak belirlenmiş bir uygulama için felaket anında en fazla 15 dakikalık veri kaybı kabul ediliyor ve uygulamanın iki saat içerisinde yeniden hizmet vermesi hedefleniyor. Ancak bu değerleri yalnızca teknik ekibin belirlemesi doğru değil. Uygulama sahiplerinin ve iş birimlerinin de sürece dahil olması gerekiyor. Çünkü altyapı ekibi teknik olarak bir sistemi iki saatte kurtarabilir ancak uygulamanın veritabanı, entegrasyonları ve kullanıcı erişimi doğrulanmadan iş sürekliliği sağlanmış sayılmaz.
Azure Local üzerinde backup mimarisi
Microsoft tarafında Azure Local sanal makinelerinin yedeklenmesi için kullanılabilecek çözümlerden birisi Microsoft Azure Backup Server, yani MABS. Bu ürün uzun süredir Microsoft’un on-premises workload koruma çözümleri arasında bulunuyor ve Azure Local üzerindeki sanal makineleri hem host seviyesinde hem de guest işletim sistemi içerisinden koruyabiliyor. Ancak Azure Local’ın Azure Arc üzerinden yönetilen VM modeline geçmesiyle beraber backup ve özellikle restore tarafında bazı önemli ayrıntılar ortaya çıkıyor.
Host-level backup modelinde koruma agent’ı Azure Local node’ları üzerine kuruluyor ve sanal makinelerin diskleriyle beraber bütün VM’nin yedeklenmesi sağlanıyor. Bu yaklaşım özellikle çok sayıda sanal makineyi merkezi olarak korumak istediğimiz ortamlarda avantajlı. Guest-level backup modelinde ise agent doğrudan sanal makinenin işletim sistemi içerisine kuruluyor. Böylece yalnızca VM’nin tamamını değil, uygulama veya veri seviyesinde ihtiyaç duyduğumuz bileşenleri de koruyabiliyoruz. Örneğin SQL Server üzerinde belirli bir veritabanının application-consistent backup ihtiyacı varsa guest seviyesinde veya uygulamaya özel bir koruma yaklaşımı daha doğru olabilir.
Burada önemli bir konu da Windows ve Linux sanal makinelerinin backup davranışlarının aynı olmaması. Microsoft’un MABS dokümantasyonunda Linux VM’ler için file-consistent snapshot desteği belirtiliyor. Dolayısıyla Linux üzerinde çalışan kritik bir veritabanının sadece VM seviyesinde yedeklenmesi, uygulamanın transaction bütünlüğünün de garanti edildiği anlamına gelmiyor. Benzer şekilde Windows üzerinde VSS kullanılması da bütün uygulamaların otomatik olarak doğru şekilde yedeklendiğini göstermiyor. İlgili uygulamanın VSS entegrasyonunun ve backup ürününün destek durumunun ayrıca kontrol edilmesi gerekiyor.
Azure Local tarafında MABS kullanırken dikkat edilmesi gereken bir diğer konu Windows Defender Application Control, yani WDAC. Azure Local güvenlik mimarisinde Application Control önemli bir bileşen ve özellikle Enforced modda çalışan ortamlarda backup agent kurulumu veya güncellenmesi etkilenebiliyor. Microsoft’un güncel dokümantasyonuna göre MABS V4 UR2 genel kullanıma açık ve gerekli supplemental policy hazırlandığında WDAC Enforced modunda agent deployment ve upgrade işlemlerini destekliyor. Daha eski MABS sürümlerinde ise agent kurulumu için Application Control yapılandırmasında geçici değişiklikler gerekebiliyor.
Bence production Azure Local ortamında backup ürününü seçerken yalnızca VM backup desteğine bakmamak gerekiyor. Kullanılan Azure Local sürümü, güvenlik baseline’ı, WDAC politikaları, storage mimarisi ve restore senaryolarının tamamı değerlendirilmelidir. Özellikle backup agent’ının kurulabilmesi için güvenlik politikalarını kalıcı olarak gevşetmek doğru bir yaklaşım değil. Desteklenen sürüm ve policy yöntemi üzerinden ilerlemek gerekiyor.
Azure Arc VM yönetiminde restore işlemi neden farklı?
Azure Local üzerinde backup tarafında en fazla dikkat edilmesi gereken konulardan birisi restore işleminin Azure Arc yönetim modeliyle ilişkisi. Klasik Hyper-V ortamında bir sanal makineyi yedekten farklı bir host üzerine geri döndürdüğünüzde VM’nin Hyper-V üzerinde çalışması çoğu zaman yeterli olabilir. Ancak Azure Local tarafında Azure Resource Manager üzerinden yönetilen sanal makinelerin yalnızca Hyper-V üzerinde çalışması yeterli değil. Aynı zamanda Azure Arc ve ilgili VM management kaynaklarıyla doğru şekilde ilişkilendirilmiş olması gerekiyor.
Microsoft’un MABS dokümantasyonunda host-level backup ve orijinal VM üzerine recovery destekleniyor. Ancak Alternate Location Recovery, yani VM’nin farklı bir konuma geri döndürülmesi senaryosunda önemli bir sınırlama bulunuyor. Bu işlem sonucunda sanal makine unmanaged VM olarak geri dönebiliyor ve bu VM’nin Azure Local VM modeline otomatik dönüştürülmesi mevcut dokümantasyonda desteklenmiyor.
Bu oldukça önemli bir ayrıntı. Çünkü backup konsolunda restore işleminin başarılı olması, VM’nin Azure portal üzerinden eski yönetim özellikleriyle kullanılabileceği anlamına gelmiyor. Sanal makine çalışıyor olabilir ancak Azure Arc lifecycle management, RBAC, VM extension ve diğer yönetim özellikleri açısından beklediğiniz durumda olmayabilir.
Örneğin Azure Local üzerinde çalışan kritik bir uygulama sunucusunu düşünelim. Bu VM’nin Azure üzerinde resource group, tag, RBAC ve monitoring yapılandırmaları bulunuyor. Bir problem sonrasında sanal makineyi farklı bir cluster’a geri döndürmek istediğinizde backup ürünü diskleri ve VM konfigürasyonunu kurtarabilir ancak Azure tarafındaki resource ilişkilerinin nasıl yeniden oluşturulacağı ayrı bir operasyon haline gelebilir.
Bu nedenle ben backup çözümünün değerlendirilmesinde yalnızca backup job başarısına değil, restore sonrasındaki yönetim modeline de bakılması gerektiğini düşünüyorum. Özellikle yeni Azure Local VM yönetim modelini kullanan kurumlarda, alternatif lokasyona restore senaryosunun pilot ortamda test edilmesi önemli.
Burada ayrıca Azure Backup servisinin public Azure üzerinde çalışan Azure VM’ler için sunduğu doğrudan VM backup deneyimiyle Azure Local backup modelini birbirine karıştırmamak gerekiyor. Azure Local VM’lerin Azure portal üzerinde resource olarak görünmesi, bu VM’lerin public Azure VM’leriyle tamamen aynı backup extension ve recovery mekanizmasına sahip olduğu anlamına gelmiyor.
Azure Site Recovery artık genel kullanıma açık
Disaster recovery tarafında ise Ekim 2026 itibarıyla önemli bir gelişme yaşandı. Microsoft, 5 Ekim 2026 tarihinde Azure Site Recovery for Azure Local özelliğinin General Availability seviyesine ulaştığını duyurdu. Daha önce Public Preview olarak kullanılan bu entegrasyon, artık desteklenen Windows ve Linux sanal makinelerinin Azure Local üzerinden Azure’a replike edilmesi, felaket durumunda Azure üzerinde çalıştırılması ve daha sonra tekrar Azure Local’a döndürülmesi için genel kullanıma açık durumda.
Bence bu gelişme Azure Local’ın hibrit bulut yaklaşımı açısından önemli. Çünkü Azure Local’ın temel kullanım senaryolarından birisi, belirli uygulamaları performans, gecikme, mevzuat veya operasyonel gereksinimler nedeniyle lokal veri merkezinde çalıştırırken Azure servislerinden yararlanabilmek. Azure Site Recovery de bu yaklaşımın iş sürekliliği tarafındaki karşılıklarından birisi.
Örneğin İstanbul’daki veri merkezimizde dört node’lu Azure Local cluster bulunduğunu düşünelim. Üzerinde ERP, SQL Server, dosya sunucuları ve farklı uygulamalar çalışıyor. Normal operasyon sırasında bu sistemlerin tamamı lokal altyapıda hizmet veriyor. Ancak veri merkezinin tamamen kullanılamaz hale gelmesi ihtimaline karşı belirli kritik VM’leri Azure Site Recovery ile uygun bir Azure bölgesine replike edebiliriz.
Bu modelde Azure Site Recovery, Azure Local üzerindeki VM disklerini Azure Storage tarafına replike ediyor. Felaket yaşandığında ise ilgili recovery point kullanılarak Azure üzerinde sanal makineler oluşturuluyor ve uygulamalar Azure altyapısında çalıştırılabiliyor. Böylece ikinci bir fiziksel veri merkezinde bütün workload’ları sürekli çalıştırmak yerine Azure’u disaster recovery hedefi olarak kullanmak mümkün hale geliyor.
Ancak burada dikkat edilmesi gereken önemli bir ayrıntı var. Azure Site Recovery bir backup ürününün alternatifi değil. Replication mekanizması veri değişikliklerini hedef ortama aktardığı için kaynak sistemde oluşan mantıksal veri bozulması veya ransomware etkisi de sonraki recovery point’lere taşınabilir. Recovery point geçmişi belirli ölçüde geri dönüş imkanı sunsa da uzun süreli, bağımsız ve güvenli backup saklama gereksinimini ortadan kaldırmaz.
Ben bu nedenle Azure Local üzerinde kritik workload’lar için backup ve Azure Site Recovery çözümlerini birbirinin alternatifi olarak değil, birbirini tamamlayan iki farklı koruma katmanı olarak değerlendiriyorum.
Azure Site Recovery mimarisi nasıl çalışıyor?
Azure Local ile Azure Site Recovery entegrasyonunda yönetim işlemleri Azure portal üzerinden gerçekleştiriliyor. Öncelikle Azure Local ortamının Azure’a kayıtlı ve gerekli internet bağlantısına sahip olması gerekiyor. Ardından Azure Local resource içerisindeki Disaster Recovery bölümünden altyapı hazırlığı başlatılabiliyor.
Bu süreçte Recovery Services vault oluşturuluyor veya mevcut bir vault seçiliyor, replication policy hazırlanıyor ve Azure Local node’larına gerekli Azure Site Recovery bileşenleri kuruluyor. Microsoft’un güncel mimarisinde ilgili agent’ların node’lara dağıtılması ve kayıt işlemleri Azure Local entegrasyonu üzerinden koordine ediliyor. İlk altyapı hazırlığı Azure Local resource üzerinden başlatılsa da sonraki replication ve recovery işlemleri Recovery Services vault üzerinden yönetiliyor.
Burada Recovery Services vault’un görevini doğru anlamak gerekiyor. Vault, replication ve recovery operasyonunun yönetim bilgilerini barındırıyor. VM verilerinin korunması için ayrıca Azure Storage kaynakları kullanılıyor. Failover gerçekleştiğinde ise hedef Azure bölgesinde uygun compute, disk ve network kaynaklarının oluşturulması gerekiyor.
Bu nedenle Azure Site Recovery maliyetini yalnızca korunan VM başına servis bedeli olarak değerlendirmek doğru değil. Replication sırasında kullanılan storage kapasitesi, veri transferi, recovery point saklama politikaları ve failover sonrasında çalışacak Azure VM’lerin compute maliyetleri de hesaba katılmalı.
Örneğin 50 VM koruyorsunuz ve bu makinelerin toplam disk kapasitesi 20 TB. Ancak 20 TB veri bulunması tek başına replication maliyetini veya gerekli network kapasitesini hesaplamak için yeterli değil. VM’lerin günlük değişen veri miktarı, replication sıklığı, hedef storage özellikleri ve recovery point gereksinimleri de önemli.
Özellikle SQL Server gibi yoğun disk yazma işlemi yapan uygulamalarda günlük veri değişim miktarı ciddi seviyelere ulaşabilir. Bu nedenle Azure Site Recovery devreye alınmadan önce Microsoft’un kapasite planlama araçlarıyla replication gereksinimlerinin değerlendirilmesi gerekiyor.
Azure Local tarafında mevcut GA desteği Windows ve Linux Generation 1 ile Generation 2 VM’lerin Azure’a failover edilmesini ve daha sonra aynı veya alternatif bir host’a failback yapılmasını kapsıyor. Ancak bu, bütün VM konfigürasyonlarının koşulsuz desteklendiği anlamına gelmiyor. Özellikle Trusted Launch, disk encryption, guest işletim sistemi, özel disk yapıları ve Azure hedef VM gereksinimleri için destek matrisinin kontrol edilmesi gerekiyor. Microsoft’un Kasım 2026 tarihli Azure Local teknik değerlendirmesinde de Trusted Launch kullanan Azure Local VM’ler için Site Recovery desteğinin bulunmadığı özellikle hatırlatılıyor.
Dolayısıyla Azure Local üzerinde Trusted Launch kullanmayı planladığımız bir VM için aynı zamanda Azure Site Recovery koruması gerekiyorsa, bu iki gereksinimin uyumluluğunu deployment öncesinde değerlendirmek önemli. Güvenlik mimarisiyle disaster recovery mimarisi birbirinden bağımsız tasarlanmamalı.
Test Failover ve gerçek felaket senaryosu
Azure Site Recovery’nin benim en fazla önem verdiğim özelliklerinden birisi Test Failover. Çünkü disaster recovery planının gerçekten çalışıp çalışmadığını öğrenmek için gerçek bir felaket yaşanmasını beklemek istemeyiz.
Örneğin Azure Local üzerinde çalışan bir ERP uygulamasını Azure’a replike ettiğimizi düşünelim. Replication işlemi sağlıklı görünüyor, recovery point’ler oluşuyor ve Azure portal üzerinde herhangi bir hata bulunmuyor. Ancak bu bilgiler bize ERP uygulamasının Azure üzerinde doğru şekilde çalışacağını garanti etmiyor.
Test Failover sayesinde production replication işlemini bozmadan Azure üzerinde izole bir test network’ünde VM’leri başlatabiliyoruz. Ardından uygulama ekipleriyle beraber işletim sistemi, servisler, veritabanı bağlantıları ve uygulama fonksiyonlarını kontrol edebiliyoruz.
Burada özellikle network mimarisine dikkat etmek gerekiyor. Çünkü Azure Local üzerinde kullandığımız IP planı, VLAN yapısı, DNS ve firewall kuralları Azure üzerinde bire bir aynı olmayabilir. Test sırasında VM’nin açılması yeterli değil. Uygulamanın diğer sistemlere nasıl erişeceği, Active Directory bağlantısının nasıl sağlanacağı, kullanıcıların uygulamaya hangi adres üzerinden bağlanacağı ve gerekli güvenlik kurallarının nasıl uygulanacağı da test edilmeli.
Bence disaster recovery projelerinde en fazla eksik bırakılan bölüm uygulama bağımlılıkları. Örneğin ERP uygulamasının web ve application sunucularını Azure’a taşıdınız ancak lisans sunucusu lokal veri merkezinde kaldı. Gerçek bir felaket durumunda lokal veri merkezi erişilemez hale geldiğinde uygulama Azure üzerinde açılsa bile lisans kontrolünü tamamlayamayabilir.
Benzer şekilde DNS sunucularının tamamı aynı Azure Local cluster üzerinde bulunuyorsa felaket sonrasında Azure VM’lerinin isim çözümlemesi yapabilmesi için gerekli altyapıyı önceden hazırlamak gerekiyor. Domain controller, DNS, sertifika servisleri, uygulama bağlantıları ve güvenlik bileşenleri disaster recovery planının parçası olmalı.
Bu nedenle Test Failover işlemini yalnızca altyapı ekibinin yaptığı bir VM açma testi olarak değerlendirmemek gerekiyor. Gerçek bir disaster recovery tatbikatında uygulama sahiplerinin de bulunması ve test sonuçlarının kayıt altına alınması önemli.
Failover sonrasında Azure Arc yönetimi
Azure Local’dan Azure’a failover işlemi gerçekleştirildiğinde sanal makinelerin yönetim modeli de değişiyor. Çünkü VM artık fiziksel olarak Azure Local üzerinde değil, public Azure altyapısında çalışıyor.
Microsoft’un güncel dokümantasyonunda bu durumla ilgili önemli sınırlamalar bulunuyor. Örneğin Azure Arc üzerinden kurulmuş VM extension’ları, failover sonrasında Azure VM üzerinde aynı yönetim modeliyle görüntülenmiyor. Azure Local resource üzerinde extension bilgileri bulunmaya devam etse bile VM Azure üzerinde çalışırken bunların Azure Arc üzerinden yönetilmesi mümkün olmayabiliyor.
Benzer şekilde Guest Configuration policy’lerinin çalışması ve monitoring verilerinin ilişkilendirilmesi de etkileniyor. Örneğin Microsoft Sentinel, Defender veya Azure Monitor üzerinden toplanan veriler failover sonrasında Azure VM resource ile ilişkilendirilebilirken, eski kayıtlar Azure Arc-enabled Server resource altında kalabiliyor. Dolayısıyla aynı makinenin geçmiş ve yeni loglarını Azure portal üzerinde farklı resource kimlikleri altında görebilirsiniz.
Bu nedenle disaster recovery planında yalnızca VM’nin Azure üzerinde çalışması değil, monitoring, security ve governance tarafındaki operasyonların nasıl devam edeceği de belirlenmeli.
Microsoft ayrıca failback ihtimali bulunan makinelerde Azure VM Guest Agent ile Azure Arc extension yönetiminin çakışmaması konusunda uyarıyor. Özellikle Azure üzerinde çalışan VM’ye yeni extension’lar kurarken veya mevcut extension’ları güncellerken, sistemin daha sonra Azure Local’a geri döneceğini dikkate almak gerekiyor.
Bence bu ayrıntılar gerçek felaket senaryolarında önemli. Çünkü disaster recovery sırasında kurumun yalnızca uygulamayı çalıştırması değil, güvenlik ve operasyon görünürlüğünü de koruması gerekiyor.
Failback planı olmadan disaster recovery tamamlanmış sayılmaz
Azure Site Recovery ile Azure Local üzerindeki sanal makineleri Azure’a replike etmek ve gerektiğinde Azure üzerinde çalıştırmak mümkün. Ancak gerçek bir disaster recovery projesinde benim en fazla önem verdiğim konulardan birisi de failback, yani sistemlerin tekrar lokal altyapıya döndürülmesi.
Örneğin İstanbul veri merkezimizde ciddi bir elektrik problemi yaşandı ve kritik sistemlerimizi Azure üzerinde çalıştırmaya başladık. İki gün sonra veri merkezi tekrar kullanılabilir hale geldi. Bu noktada uygulamaları yeniden Azure Local’a taşımamız gerekiyor.
Ancak burada yalnızca Azure VM’lerini kapatıp eski Azure Local VM’lerini açmak doğru değil. Çünkü uygulamalar iki gün boyunca Azure üzerinde çalıştı ve yeni veriler oluştu. Bu değişikliklerin tekrar lokal ortama aktarılması gerekiyor.
Azure Site Recovery bu amaçla re-protection ve failback mekanizmalarını destekliyor. Azure üzerinde çalışan VM’lerin verileri tekrar Azure Local’a replike edilebiliyor, ardından kontrollü geçişle sistemler lokal ortamda çalıştırılabiliyor. Microsoft’un güncel dokümantasyonuna göre Windows ve Linux Generation 1/2 VM’ler için aynı host’a veya alternatif host’a failback senaryoları destekleniyor.
Ancak burada dikkat edilmesi gereken bir diğer konu Azure Local VM kaynaklarının yönetim durumu. Microsoft, failover sonrasında Azure Local üzerindeki VM resource silinirse yeniden Azure Local yönetim modeline dönmek için manuel müdahale gerekebileceğini belirtiyor.
Bu nedenle disaster recovery sırasında kaynak VM’leri silmek veya kaynak altyapıyı tamamen yeniden oluşturmak gibi işlemler önceden planlanmadan yapılmamalı. Özellikle Arc resource kimliği, VM management ilişkileri ve backup yapılandırmaları failback sonrasında yeniden doğrulanmalı.
Bence Azure Site Recovery projesinin tamamlandığını söylemek için yalnızca Azure’a failover testinin başarılı olması yeterli değil. En azından pilot ortamda Azure’dan Azure Local’a dönüş senaryosunun da test edilmesi gerekiyor.
Stretched Cluster ve uygulama seviyesinde disaster recovery
Azure Local üzerinde disaster recovery planlarken tek seçeneğimiz Azure Site Recovery değil. Kurumun ihtiyaçlarına göre farklı mimariler de kullanılabilir.
Örneğin birbirine yakın iki veri merkezi bulunan bir kurumda stretched cluster mimarisi değerlendirilebilir. Bu modelde uygun donanım, storage ve network koşulları sağlandığında cluster kaynaklarının iki fiziksel lokasyona dağıtılması mümkün. Ancak stretched cluster’ı bütün felaket senaryolarını çözen bir yapı olarak değerlendirmemek gerekiyor.
Çünkü stretched cluster öncelikle yüksek erişilebilirlik ve site seviyesinde dayanıklılık sağlamayı hedefliyor. İki lokasyon arasındaki gecikme, bağlantı kapasitesi, witness yapılandırması ve storage replication davranışı mimarinin başarısını doğrudan etkiliyor. Ayrıca verinin iki lokasyonda bulunması, geçmişteki temiz bir veri kopyasına geri dönebileceğiniz anlamına gelmiyor.
Benzer şekilde SQL Server gibi kritik uygulamalarda yalnızca VM seviyesinde disaster recovery yeterli olmayabilir. Microsoft, Azure Local üzerinde SQL Server için Always On Availability Groups, Failover Cluster Instances, Log Shipping ve diğer SQL-native koruma yöntemlerini destekliyor.
Örneğin yoğun transaction üreten bir SQL Server için düşük RPO beklentiniz varsa, SQL Server Always On Availability Groups kullanarak ikinci bir lokasyonda database replica oluşturmak daha uygun olabilir. Bu modelde senkron veya asenkron replication tercihi uygulamanın performans ve veri kaybı beklentisine göre yapılır.
Ancak SQL Server Always On kullanılması da bütün uygulamanın otomatik olarak korunduğu anlamına gelmiyor. Uygulama sunucuları, network bağlantıları, DNS, SQL listener, login’ler, job’lar ve diğer bağımlılıkların da planlanması gerekiyor.
Bence burada doğru yaklaşım her workload için aynı disaster recovery ürününü seçmek yerine, uygulamanın gereksinimine göre farklı koruma katmanlarını beraber kullanmak. Örneğin kritik SQL Server veritabanı için Always On, uygulama sunucuları için Azure Site Recovery ve uzun süreli veri koruması için ayrı backup politikası kullanılabilir.
Ransomware senaryosunda backup ve replication
Günümüzde backup ve disaster recovery mimarisini değerlendirirken ransomware konusunu ayrıca ele almak gerekiyor. Çünkü klasik felaket senaryolarında genellikle fiziksel donanım arızası veya veri merkezi kesintisi düşünülüyor. Ancak ransomware saldırısında fiziksel altyapı tamamen sağlıklı olabilirken verilerin kullanılamaz hale gelmesi mümkün.
Örneğin Azure Local üzerinde çalışan bir dosya sunucusunun verileri şifrelendiğinde Storage Spaces Direct aynı şifrelenmiş veriyi diğer disklerde de koruyacaktır. Azure Site Recovery ise değişen disk bloklarını replication mekanizması üzerinden hedef ortama aktarabilir.
Bu nedenle ransomware senaryosunda replication tek başına yeterli koruma sağlamaz.
Burada geçmişteki temiz recovery point’lere dönebilmek, backup kopyalarını üretim ortamından ayrı tutmak, backup yönetim yetkilerini sınırlandırmak ve mümkünse immutable backup storage kullanmak önemli. Ancak immutable backup özelliğinin kullanılan backup ürünü ve storage hedefi tarafından gerçekten desteklenmesi gerekiyor. Azure üzerinde bir Recovery Services vault oluşturmuş olmak, Azure Local VM’lerinin bütün backup kopyalarının otomatik olarak immutable hale geldiği anlamına gelmiyor.
Ben backup mimarisinde mümkün olduğunca 3-2-1 yaklaşımını ve kritik sistemlerde bunun offline veya immutable kopyalarla güçlendirilmesini tercih ediyorum. Burada amaç sadece birden fazla backup kopyası oluşturmak değil, saldırganın production sistemlere erişim sağladığında bütün backup kopyalarını da silememesini sağlamak.
Özellikle backup yönetim hesaplarının production administrator hesaplarından ayrılması, MFA ve uygun RBAC politikalarının uygulanması, backup retention ayarlarının korunması ve restore işlemlerinin düzenli olarak test edilmesi önemli.
Çünkü ransomware sonrasında asıl ihtiyacımız olan şey backup job’larının geçmişte başarılı görünmesi değil, temiz ve kullanılabilir bir recovery point üzerinden sistemi yeniden çalıştırabilmek.
Production ortamında nasıl bir koruma modeli oluştururdum?
Ben Azure Local üzerinde kritik bir production ortamı tasarlarken öncelikle bütün sanal makineleri aynı backup veya disaster recovery grubuna koymazdım. Uygulamaları iş kritikliği, RPO ve RTO beklentilerine göre sınıflandırırdım. Örneğin ERP, SQL Server, Active Directory ve üretim sistemleriyle test veya geliştirme sunucularının aynı koruma politikasına sahip olması çoğu zaman doğru değil.
Ardından backup mimarisini belirlerdim. VM seviyesinde yedekleme gereksinimi bulunan sistemler için Azure Local’ı destekleyen bir backup ürünü kullanır, uygulama seviyesinde veri bütünlüğü gerektiren sistemlerde ise guest-level veya application-aware backup yöntemlerini değerlendirirdim. Backup kopyalarının yalnızca aynı Azure Local cluster üzerinde bulunmamasına dikkat ederdim. Çünkü bütün yedeklerin koruduğumuz altyapıyla aynı fiziksel risk alanında bulunması, veri merkezi felaketi durumunda ciddi problem oluşturabilir.
Disaster recovery tarafında ise kritik VM’ler için Azure Site Recovery’yi değerlendirirdim. Ancak bütün VM’leri otomatik olarak Azure’a replike etmek yerine gerçekten düşük RTO gereksinimi bulunan uygulamaları önceliklendirirdim. Çünkü her VM’nin replication ve recovery maliyeti bulunuyor. Ayrıca Azure üzerinde failover sırasında çalışacak VM boyutları, disk tipleri, network yapısı ve gerekli servislerin önceden hazırlanması gerekiyor.
Özellikle Active Directory ve DNS tarafında ayrı bir plan oluştururdum. Çünkü felaket anında uygulama sunucularını Azure üzerinde çalıştırmak istiyorsak kimlik doğrulama ve isim çözümleme servislerinin de erişilebilir olması gerekiyor. Burada her domain controller’ı klasik VM replication ile korumak yerine Active Directory’nin kendi replication ve recovery mimarisini dikkate almak daha doğru olabilir. Aynı şekilde SQL Server gibi uygulamalarda native HA/DR özelliklerini de değerlendirirdim.
Sonrasında düzenli test takvimi hazırlardım. Örneğin belirli aralıklarla dosya veya veritabanı restore testi, daha seyrek ama planlı şekilde bütün VM restore testi ve kritik uygulamalar için Azure Site Recovery Test Failover gerçekleştirirdim. Bu testlerin sonunda yalnızca VM’nin açılıp açılmadığını değil, uygulamanın gerçekten çalışıp çalışmadığını ve hedeflenen RTO/RPO değerlerine ulaşılıp ulaşılmadığını kayıt altına alırdım.
Bence burada özellikle recovery süresini ölçmek önemli. Çünkü kağıt üzerinde iki saatlik RTO belirlemek kolay ancak gerçek bir felaket sırasında network, DNS, firewall, uygulama bağımlılıkları ve kullanıcı erişimiyle beraber bu sürenin sağlanıp sağlanamayacağını ancak test ederek öğrenebiliriz.
Bir diğer konu maliyet. Azure Site Recovery sayesinde ikinci bir fiziksel veri merkezinin bütün maliyetlerini taşımadan Azure’u disaster recovery hedefi olarak kullanmak mümkün. Ancak bunun sıfır maliyetli bir çözüm olmadığını unutmamak gerekiyor. Replication storage, servis ücretleri, veri transferi ve failover sırasında oluşacak compute maliyetleri hesaba katılmalı. Aynı şekilde backup tarafında da saklama süresi, veri büyümesi, immutable storage ve offsite kopya gereksinimleri toplam maliyeti etkiliyor.
Özellikle uzun süreli retention gerektiren kurumlarda backup maliyetinin yalnızca ilk yıl için değil, veri büyümesiyle beraber birkaç yıllık dönem için hesaplanması daha doğru.
Azure Local’ın yüksek erişilebilirlik özellikleri sayesinde fiziksel node veya disk arızalarında workload’larımızı koruyabiliyoruz. Microsoft Azure Backup Server veya desteklenen üçüncü parti backup çözümleriyle geçmişteki veri ve sistem durumlarına geri dönebiliyoruz. Azure Site Recovery sayesinde ise desteklenen VM’leri Azure’a replike ederek veri merkezi felaketi durumunda farklı bir altyapı üzerinde çalıştırabiliyoruz.
Ancak bütün bu teknolojilerin başarılı olması için birbirleriyle uyumlu bir mimari oluşturmak gerekiyor. Özellikle Azure Arc VM yönetimi, backup restore sınırlamaları, Trusted Launch desteği, uygulama bağımlılıkları ve failback süreçleri proje aşamasında değerlendirilmezse felaket anında beklenmeyen sorunlarla karşılaşmak mümkün.
Özetle Azure Local üzerinde backup ve disaster recovery planlamak yalnızca yedekleme yazılımı kurmak veya VM replication başlatmak değil. Asıl önemli olan, hangi problem yaşanırsa yaşansın uygulamanın kabul edilen veri kaybı ve kesinti süresi içerisinde yeniden hizmet verebilmesini sağlamak. Bunu da ancak doğru mimari, düzenli test ve iyi hazırlanmış operasyon prosedürleriyle gerçekleştirebiliriz.
Bir sonraki makalede ise Azure Local üzerinde container ve Kubernetes altyapısına geçerek AKS Enabled by Azure Arc ile Azure Local Üzerinde Kubernetes konusunu inceleyeceğiz.