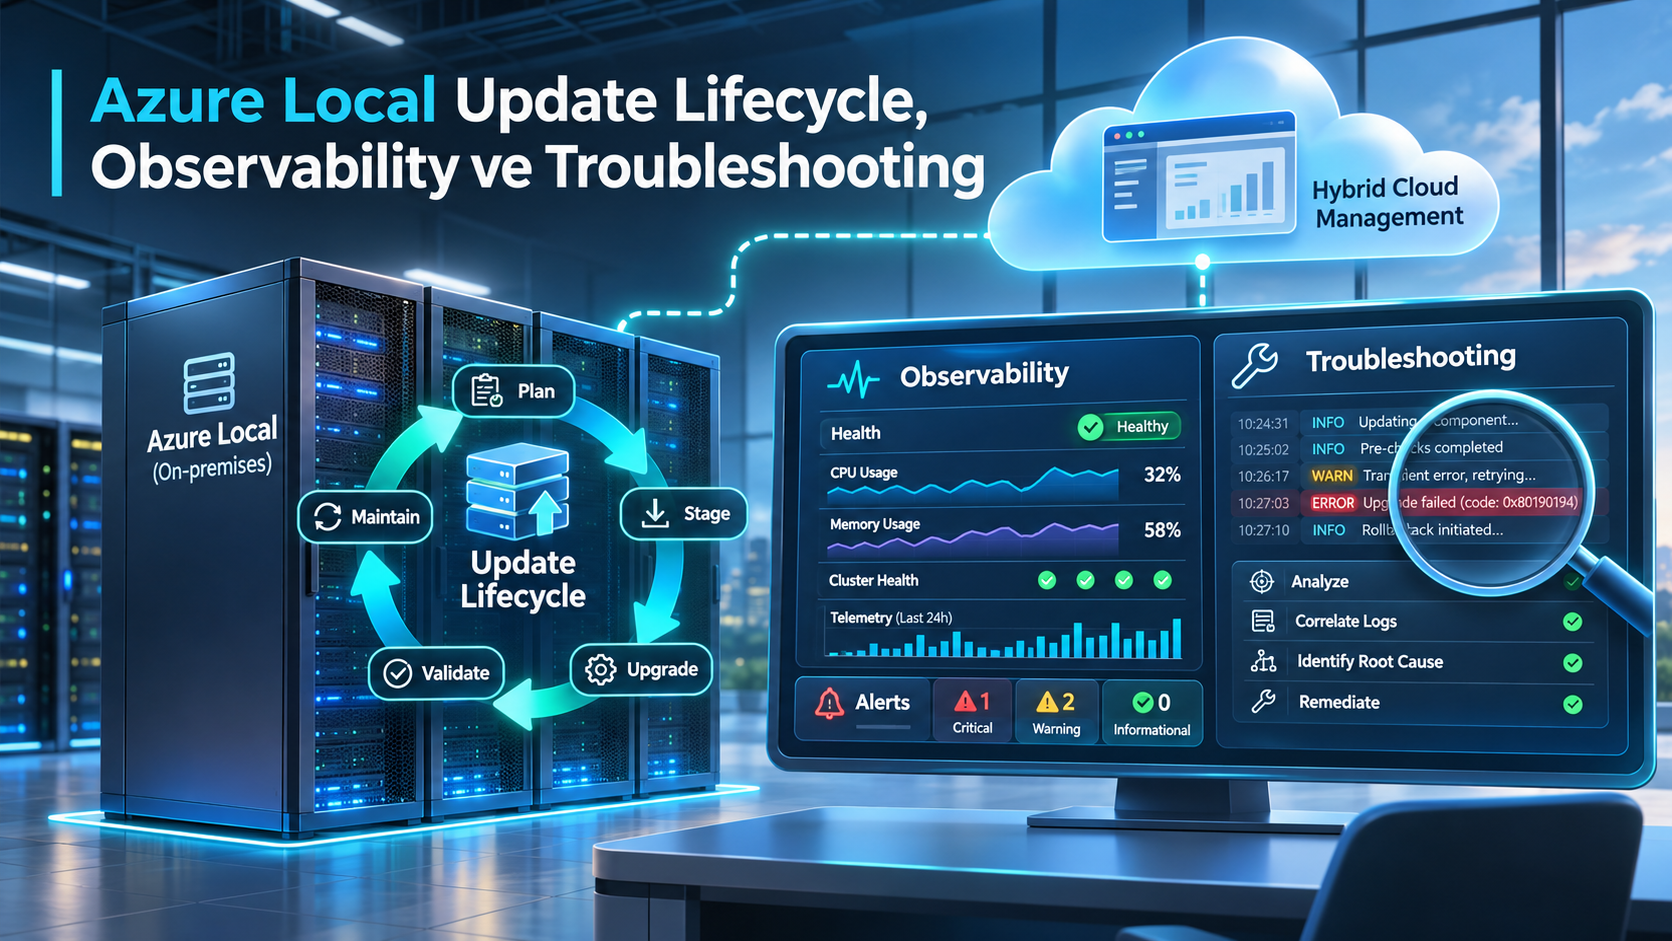
Azure Local projelerinde kurulum tamamlandıktan sonra en fazla dikkat edilmesi gereken konulardan biri platformun yaşam döngüsü yönetimi.
Dört node’lu bir Azure Local cluster kurduğunuzu düşünelim. Network ATC yapılandırılmış, Storage Spaces Direct çalışıyor, sanal makineler oluşturulmuş ve uygulamalar production ortamına alınmış. Yani ortam çiçek gibi :)
İlk birkaç ay her şey sorunsuz çalışabilir. Ancak bir süre sonra işletim sistemi güncellemeleri, firmware değişiklikleri, yeni driver sürümleri ve Azure Local platform güncellemeleri gelmeye başlıyor. Klasik Windows Server veya Hyper-V ortamlarında bu süreçleri genellikle Windows Update, WSUS, Configuration Manager, Cluster-Aware Updating veya donanım üreticisinin yönetim araçlarıyla gerçekleştiriyorduk. Azure Local tarafında ise güncelleme yaklaşımı farklı. Çünkü Azure Local yalnızca Windows Server tabanlı bir sanallaştırma platformu değil. İşletim sistemi, cluster servisleri, Azure Arc bileşenleri, management agent’ları ve donanım üreticisinin sağladığı bileşenlerin beraber çalıştığı bir çözüm. Yani onprem servisler kadar üzerinde cloud servisleri de çalışıyor. Dolayısıyla sadece işletim sistemini güncellemek, platformun tamamını güncel tutmak anlamına gelmiyor. Hatta bazı durumlarda fiziksel node’lara manuel güncelleme uygulamak, Azure Local’ın beklediği konfigürasyonu bozabiliyor. Bence Azure Local operasyonlarında en önemli değişikliklerden biri bu.
Artık tek tek sunucuların değil, bütün platformun yaşam döngüsünü yönetiyoruz.
Üstelik güncelleme işlemi tek başına yeterli değil. Güncelleme öncesinde sistemin sağlıklı olduğunu doğrulamamız, güncelleme sırasında neler olduğunu takip etmemiz ve işlem tamamlandıktan sonra workload’ların beklediğimiz şekilde çalıştığından emin olmamız gerekiyor. Bu nedenle Azure Local Update Lifecycle, Observability ve Troubleshooting konularını birbirinden bağımsız değerlendirmek doğru değil. Üçü aynı operasyonel sürecin farklı parçaları.
Azure Local Solution Update mimarisi
Azure Local güncelleme mimarisinin merkezinde Solution Update yaklaşımı bulunuyor. Microsoft, Azure Local için işletim sistemi, platform servisleri, agent’lar ve desteklenen donanım bileşenlerini koordineli şekilde güncelleyebilen bir yapı sunuyor. Bu yapının önemli bileşenlerinden biri Lifecycle Manager. Lifecycle Manager, Azure Local deployment sırasında kurulan orchestrator bileşenleriyle beraber çalışarak güncelleme süreçlerini yönetiyor. Mevcut cluster ortamımız için yeni bir Azure Local sürümü yayımlanmış olsun, bu sürüm işletim sistemi güncellemeleri, platform servisleri ve belirli agent değişiklikleri içeriyor olabilir. Donanım üreticisinin desteklediği bir Solution Builder Extension paketi varsa firmware ve driver güncellemeleri de aynı yaşam döngüsü içerisinde değerlendirilebilir. Burada önemli olan bütün bileşenlerin rastgele sırayla güncellenmemesi.
Microsoft’un update orchestrator mekanizması, güncelleme paketlerini ve gerekli ön koşulları değerlendirerek işlemleri belirli bir sırayla gerçekleştiriyor. Cluster-Aware Updating ise uygun güncelleme aşamalarında node’ların sırayla güncellenmesine yardımcı oluyor. Ancak bu noktada bir ayrıntıya dikkat etmek gerekiyor. Cluster-Aware Updating kullanılması, bütün güncellemelerin sıfır kesintiyle tamamlanacağını garanti etmiyor. Örneğin yeterli boş kapasite bulunmayan bir cluster’da node maintenance işlemi workload’ları etkileyebilir. Benzer şekilde guest işletim sistemi, uygulama veya sanal makine konfigürasyonundan kaynaklanan bazı durumlar Live Migration işlemini engelleyebilir. Dolayısıyla Azure Local’ın rolling update yeteneğini yüksek erişilebilirlik mimarisinin bir parçası olarak değerlendirmek gerekiyor. Tek başına kesintisiz operasyon garantisi olarak değil.
Solution Update ile Windows Update arasındaki fark
Azure Local üzerinde en fazla kaçınılması gereken yaklaşımlardan biri, fiziksel node’ları birbirinden bağımsız Windows Server sistemleri gibi güncellemek. Dört node’lu ortamımız için bir sistem yöneticisi Node01 üzerine Windows Update üzerinden güncelleme kuruyor. Başka bir sistem yöneticisi Node02 üzerinde firmware güncellemesi gerçekleştiriyor. Üçüncü node üzerinde farklı bir network driver sürümü bulunuyor. Dördüncü node ise henüz güncellenmemiş. Bu durumda cluster çalışmaya devam edebilir. Ancak platformun beklediği doğrulanmış bileşen kombinasyonu bozulmuş olabilir. Özellikle storage, network ve cluster servislerinin beraber çalıştığı yapılarda driver ve firmware uyumluluğu önemli. Microsoft bu nedenle Azure Local güncellemelerinin desteklenen Solution Update mekanizmaları üzerinden uygulanmasını istiyor. Azure Update Manager, Azure Local resource sayfası ve Microsoft tarafından belgelenmiş PowerShell güncelleme yöntemleri bu kapsamda bulunuyor. Üçüncü parti araçlarla veya node’lara bağımsız şekilde manuel güncelleme uygulanması desteklenen yöntem değil. Burada dikkat edilmesi gereken konu, bütün üçüncü parti yönetim araçlarının yasak olduğu anlamına gelmemesi. Örneğin kurumunuz monitoring, inventory veya security operasyonları için farklı ürünler kullanıyor olabilir. Ancak Azure Local platformunun güncellenmesi söz konusu olduğunda Microsoft’un desteklediği update workflow kullanılmalı. Bence Azure Local’a geçen kurumların mevcut patch management politikalarında yapması gereken ilk değişikliklerden biri bu. Fiziksel Azure Local node’larını standart Windows Server patch deployment gruplarından ayrı değerlendirmek gerekiyor.
Solution Builder Extension neden önemli?
Azure Local güncelleme mimarisinin önemli bileşenlerinden biri de Solution Builder Extension, yani SBE.
SBE, donanım üreticisinin Azure Local için sağladığı ve Microsoft’un lifecycle mekanizmasıyla entegre çalışan bileşenleri kapsıyor. Burada firmware, driver ve donanıma özel güncelleme içerikleri bulunabiliyor. Örneğin bir Azure Local cluster üzerinde belirli bir network adapter modeli kullanıyorsunuz. Microsoft yeni bir Azure Local sürümü yayımladı. Ancak ilgili network adapter için gerekli driver veya firmware sürümü henüz donanım üreticisi tarafından doğrulanmamış olabilir. Bu durumda Microsoft’un yeni sürümü yayımlaması, sizin cluster’ınızın aynı gün güncellemeye hazır olduğu anlamına gelmiyor. Donanım üreticisinin validation süreci tamamlanmalı.
Microsoft’un güncel dokümantasyonuna göre feature update’lerin kullanılabilir hale gelmesi donanım modeline ve SBE doğrulama sürecine bağlı olarak değişebiliyor. Hatta 2608 sürümüyle beraber güncelleme durumlarına Pending OEM Validation bilgisi eklendi. Bu durum güncellemenin donanım üreticisinin doğrulamasını beklediğini gösteriyor. Bence bu özellik özellikle büyük kurumlarda güncelleme planlaması açısından önemli. Çünkü güvenlik ekibi yeni sürüm yayımlandığı için güncellemenin hemen uygulanmasını isteyebilir. Ancak altyapı ekibi ilgili sürümün kendi donanımı için henüz doğrulanmadığını görebilir. Burada yapılması gereken şey güncellemeyi farklı yöntemlerle zorlamak değil. Donanım üreticisinin destek durumunu kontrol etmek ve uygun update path üzerinden ilerlemek. Ayrıca bütün Azure Local donanım çözümlerinin aynı SBE özelliklerini sunduğunu düşünmemek gerekiyor. Desteklenen güncelleme ve otomatik indirme yetenekleri kullanılan OEM çözümüne göre değişebiliyor.
Azure Local 2610 sürümünde neler değişti?
Bu makaleyi hazırladığım 29 Ekim 2026 itibarıyla Azure Local’ın en güncel hyperconverged sürümü 2610. Microsoft, 22 Ekim 2026 tarihinde 12.2610.1004.41 sürümünü yayımladı.
Bu sürümde kullanılan işletim sistemi build numarası 26100.33650. 2610 sürümüyle beraber güncelleme ve troubleshooting açısından dikkat çeken birkaç yenilik bulunuyor. Bunlardan ilki işletim sistemi ve OEM bileşenlerinin güncellenmesiyle ilgili. Microsoft, 2610 ile beraber işletim sistemi ve SBE bileşenlerinin aynı koordineli Cluster-Aware Updating çalışması içerisinde güncellenebilmesini destekliyor. Bunun amacı güncelleme süresini azaltmak ve workload üzerindeki operasyonel etkiyi sınırlamak. Ancak bu özellik her donanımda otomatik olarak aynı şekilde çalışacak anlamına gelmiyor. Kullanılan OEM çözümünün ilgili update workflow’u desteklemesi gerekiyor. İkinci önemli yenilik health check tarafında. 2610 sürümüyle beraber Get-SolutionHealthSummary PowerShell komutu kullanıma sunuldu. Bu komut, en son solution health check sonuçlarının özetini görüntülemeyi sağlıyor. Özellikle kritik ve müdahale gerektiren sorunları daha kolay belirleyebilmek açısından önemli. Üçüncü yenilik ise diagnostic log toplama tarafında. 2610 ile beraber SANDiagnostics isimli yeni bir log filtreleme rolü eklendi. Bu rol özellikle SAN storage kullanılan ortamlarda MPIO, Fibre Channel, iSCSI initiator, disk, volume, Cluster Shared Volume ve ilgili event log bilgilerinin toplanmasına yardımcı oluyor. Bence bu özellik Azure Local’ın yalnızca Storage Spaces Direct kullanılan klasik HCI mimarisiyle sınırlı kalmamasının operasyonel karşılıklarından biri. Özellikle disaggregated mimarilerde storage troubleshooting farklı bileşenlerin beraber incelenmesini gerektiriyor. Bu nedenle SAN tarafına özel diagnostic toplama yeteneğinin bulunması önemli. Burada ayrıca 2610 ile gelen güvenlik güncellemelerini de unutmamak gerekiyor. Security baseline kapsamı 408 ayardan 429 ayara genişletildi. Bu konu doğrudan update lifecycle’ın parçası olmasa da platform güncellemesinin yalnızca işletim sistemi patch’lerinden oluşmadığını gösteriyor.
Yeni bir Azure Local sürümüne geçerken güvenlik baseline davranışında da değişiklikler olabileceğini değerlendirmek gerekiyor.
Güncelleme öncesi hazırlık neden önemli?
Azure Local üzerinde güncelleme işlemini başlatmadan önce yapılması gereken kontroller var. Microsoft bu kontrolleri readiness check mekanizmasıyla gerçekleştiriyor. Ancak burada iki farklı kontrol türü bulunuyor.
Birincisi System Health Check.
İkincisi Update Readiness Check.
System Health Check, mevcut Azure Local sürümünün doğrulama mekanizmalarıyla sistemin sağlık durumunu değerlendiriyor. Bu kontroller 24 saatlik aralıklarla gerçekleştiriliyor. Update Readiness Check ise kurulacak güncellemenin kendi doğrulama mekanizmalarını kullanıyor. Dolayısıyla mevcut sistem health check sonuçları başarılı olsa bile yeni güncellemenin readiness kontrolü başarısız olabilir. Bu durum her zaman bir çelişki değil. Çünkü iki kontrol farklı doğrulama sürümleri kullanabiliyor. Örneğin mevcut Azure Local sürümünde problem oluşturmayan bir konfigürasyon, yeni sürümün gereksinimlerini karşılamıyor olabilir. Bu nedenle sadece Azure portal üzerinde cluster’ın Healthy görünmesine bakarak güncelleme başlatmak doğru değil. Güncelleme öncesi readiness sonuçlarını ayrıca değerlendirmek gerekiyor. Microsoft bu kontrolleri üç seviyede sınıflandırıyor. Critical, Warning ve Informational. Critical seviyesindeki sorunlar güncellemenin başlamasını engelliyor. Warning seviyesindeki sorunlar da varsayılan olarak güncellemeyi engelliyor ancak desteklenen yöntemlerle belirli durumlarda bypass edilebiliyor. Informational seviyesindeki kontroller ise bilgilendirme amacı taşıyor. Bence burada özellikle Warning seviyesindeki sorunlara dikkat etmek gerekiyor. Çünkü Warning gördüğümüzde bunu önemsenmeyen bir uyarı olarak değerlendirmek kolay. Oysa Microsoft’un update workflow’unda Warning kontrolleri de varsayılan olarak engelleyici. PowerShell üzerinden IgnoreWarnings parametresi kullanılabiliyor olması, her uyarının güvenle atlanabileceği anlamına gelmiyor. Örneğin storage kapasitesi veya cluster health ile ilgili bir uyarıyı dikkate almadan güncelleme başlatmak ciddi risk oluşturabilir. Ben production ortamında böyle bir durumda önce uyarının nedenini araştırmayı tercih ederim.
Prepare Updates ile bakım süresini azaltmak
Azure Local güncelleme sürecinde son dönemde gelen önemli yeniliklerden biri Prepare Updates. Microsoft bu özelliği 2608 sürümündeki yenilikler arasında duyurdu. Azure portal üzerinden hazırlık iş akışını kullanabilmek için cluster’ın en az 12.2604.1003.28 sürümünde olması gerekiyor. Bu özellik sayesinde güncelleme paketlerini önceden indirebiliyor, paket doğrulamalarını gerçekleştirebiliyor ve readiness kontrollerini çalıştırabiliyoruz. Ancak güncellemenin kurulumu başlamıyor. Örneğin bir kurumda production Azure Local cluster’ının yalnızca pazar gecesi güncellenmesine izin verildiğini düşünelim. Klasik yaklaşımda pazar gecesi güncelleme başlatılıyor.
Önce paketler indiriliyor.
Ardından doğrulamalar gerçekleştiriliyor.
Sonrasında kurulum başlıyor.
Bu süreç maintenance window içerisinde gereksiz zaman tüketebilir.
Prepare Updates kullanıldığında ise paket indirme ve hazırlık işlemleri daha önce tamamlanabiliyor.
Bakım penceresi geldiğinde hazır güncellemenin kurulumu başlatılabiliyor.
Bence özellikle büyük update paketlerinde bu yaklaşım önemli.
Ancak burada bir ayrıntı var.
Prepare işleminin başarılı olması, güncelleme gününde sistemin hala aynı sağlık durumunda olacağını garanti etmiyor.
Microsoft’un güncel dokümantasyonuna göre ReadyToInstall durumundaki bir güncellemenin health check sonuçları varsayılan olarak üç gün sonra geçerliliğini kaybedebiliyor.
Bu durumda güncelleme başlatıldığında readiness kontrolleri yeniden çalıştırılıyor.
Dolayısıyla bir hafta önce Prepare işlemini başarıyla tamamlamış olmak, bir hafta sonra bütün kontrollerin atlanacağı anlamına gelmiyor.
Bence bu doğru bir davranış.
Çünkü aradan geçen sürede cluster üzerinde disk arızası, kapasite problemi veya farklı bir konfigürasyon değişikliği oluşmuş olabilir.
Güncelleme sırasında workload’lara ne oluyor?
Azure Local üzerinde güncelleme yapılırken en çok merak edilen konulardan biri sanal makinelerin durumu. Özellikle production ortamında çalışan ERP, SQL Server veya kritik uygulama sunucularının güncellemeden etkilenmemesi bekleniyor. Azure Local, Cluster-Aware Updating ve cluster orchestration mekanizmalarını kullanarak uygun güncelleme işlemlerini node bazında koordine edebiliyor. Mevcut cluster ortamımız için (makalemin başından itibaren dört node’lu bir cluster üzerinden ilerliyorum) Node01 güncellenecek. Önce bu node üzerindeki workload’ların uygun şekilde diğer node’lara taşınması gerekiyor. Ardından node maintenance işlemleri ve gerekli güncellemeler gerçekleştiriliyor. Node yeniden başlatıldıktan sonra cluster’a sağlıklı şekilde katılması bekleniyor. Sonrasında diğer node’lara geçilebiliyor. Ancak bu senaryonun sorunsuz çalışması için cluster’ın yeterli kapasiteye sahip olması gerekiyor. Ortamda bütün node’ların CPU ve memory kaynakları zaten yoğun kullanılıyorsa bir node maintenance durumuna alındığında kalan node’ların workload’ları taşıması zorlaşabilir.
Aynı şekilde Storage Spaces Direct üzerinde repair veya rebalance işlemleri devam ediyorsa güncelleme öncesinde bunların değerlendirilmesi gerekiyor. Benzer şekilde kritik bir disk arızası bulunan cluster’da update başlatmak doğru yaklaşım değil. Burada önemli olan yalnızca update orchestrator’ın teknik olarak çalışması değil. Cluster’ın güncelleme sırasında bir node eksik çalışabilecek kapasiteye sahip olması.
Bence Azure Local kapasite planlamasında N+1 yaklaşımının önemli olmasının nedenlerinden biri de bu. Kapasite planlama makalesinde anlattığımız konular doğrudan update lifecycle ile ilişkili.
Yeterli kapasite bırakılmamış bir cluster’ın maintenance operasyonlarını sağlıklı gerçekleştirmesi zorlaşabilir. Bu noktada tabi ki bizlerin henüz bu tür projelerin başında yaptığımız sizing çalışması çok önemli. Bazen uzmanlığımızdan dolayı donanımı başka bir tedarikçisinin temin ettiği projelerde sadece bizlerden kurulum ve bakım hizmeti alınıyor. Ancak bu durumlarda ne yazık ki geleneksel donanım tedarikçilerinin bu konuya ne kadar uzak olduklarını anlıyoruz. Malum çok uzun yıllardır geleneksel veya Vmware ortamlarının sağladığı HCI platformları için kitlist hazırladıkları için bırakın Azure Local’ i Hyper-V için bile çok yetersiz kalıyorlar.
Azure Local sürümlerinde destek süresi
Azure Local güncelleme planlamasında dikkat edilmesi gereken bir diğer konu support lifecycle. Microsoft’un güncel release information dokümantasyonuna göre Azure Local sürümlerinin destek süresi altı ay. Bu oldukça önemli. Çünkü klasik Windows Server ortamlarında yıllarca aynı işletim sistemi sürümünü kullanmaya alışmış kurumlar bulunuyor. Azure Local tarafında ise platform güncellemelerini uzun süre ertelemek destek kapsamı açısından problem oluşturuyor. Microsoft, altı ay içerisinde güncellenmeyen Azure Local sürümlerinin destek kapsamından çıktığını belirtiyor. Üstelik bu durum sadece yeni özellikleri kullanamamak anlamına gelmiyor. Destek dışı kalan sürümlerde Microsoft Support, normal troubleshooting ve root cause analysis işlemlerinden önce sistemin desteklenen bir sürüme güncellenmesini isteyebiliyor. Bu nedenle Azure Local güncellemelerini yalnızca güvenlik ekibinin patch management takvimine bırakmamak gerekiyor. Ayrı bir platform lifecycle planı hazırlanmalı. Örneğin kurumunuz yılda yalnızca iki kez altyapı güncellemesi yapıyorsa bu takvimin Azure Local destek süreleriyle uyumlu olduğundan emin olmanız gerekiyor. Bir diğer önemli konu Azure Arc Resource Bridge. Microsoft, Resource Bridge sertifikalarının geçerliliğini ve VM management fonksiyonlarının çalışmasını korumak için solution update’lerin bir yıl içerisinde uygulanması gerektiğini belirtiyor. Ancak bunu altı aylık Azure Local destek süresinin alternatifi olarak değerlendirmemek gerekiyor. Azure Local platformunun desteklenen sürümde tutulması için daha kısa olan güncelleme gereksinimi esas alınmalı. Bence Azure Local operasyonlarında en önemli disiplinlerden biri düzenli güncelleme takvimi oluşturmak. Bu disiplin ilk bakışta sizleri çok zorlayacak gibi görünse de aslında sistemleri güncel tutmak için çok iyi bir alışkanlık. Bunun önce cloud ortamlarındaki örneğin AKS gibi platformlarda gördük, Microsoft ve benzeri cloud sağlayıcıları ortamlarınız 6 ayda bir güncellemek zorunda bıraktı, önceleri yazılım ve devops ekipleri isyan ederken artık çok daha sorunsuz ilerlediklerini paylaşıyorlar. Şimdi sıra sistemci arkadaşlarda. Özetle bu işten gözünüz korkmasın, tam tersi emin olun yılda kesin en az iki güncelleme ortamları çok daha kararlı bir hale sokuyor.
Not: Azure Local üzerinde de biliyorsunuz AKS var :)
Daha önemlisi güncellemeleri uzun süre ertelemek yalnızca security risk oluşturmuyor.Daha sonra uygulanması gereken update path’i de karmaşık hale getirebiliyor.
Observability sadece monitoring değil
Azure Local üzerinde monitoring konusu da klasik Windows Server ortamlarından biraz farklı. Çünkü burada yalnızca CPU, memory veya disk kullanımını izlemek yeterli değil. Platformun farklı katmanlarını beraber değerlendirmek gerekiyor.
Fiziksel donanım.
Cluster servisleri.
Storage Spaces Direct.
Network ATC.
Azure Arc bileşenleri.
VM workload’ları.
Update lifecycle.
Bu bileşenlerin her biri farklı sağlık ve performans bilgileri üretiyor. Microsoft Azure Local observability mimarisini üç temel veri akışı üzerinden tanımlıyor. Telemetry, Diagnostics ve Monitoring. Telemetry, platformun çalışma durumu ve davranışıyla ilgili belirli bilgilerin toplanmasını sağlıyor. Diagnostics, özellikle sorun giderme sırasında daha ayrıntılı logların toplanması için kullanılıyor. Monitoring ise sistemin performans ve sağlık durumunun sürekli takip edilmesini sağlıyor. Burada önemli olan bu üç yapının aynı şey olmaması. Örneğin Azure Monitor üzerinde CPU kullanımını görüntülemek, bütün diagnostic logların toplandığı anlamına gelmiyor. Benzer şekilde Microsoft Support için diagnostic log göndermek, kurumun merkezi monitoring sisteminin doğru yapılandırıldığı anlamına gelmiyor. Bence production Azure Local ortamında bu üç katmanın ayrı ayrı değerlendirilmesi gerekiyor.
Azure Monitor Metrics ve Insights farkı
Azure Local üzerinde monitoring için Azure Monitor entegrasyonu bulunuyor. Burada Metrics ve Insights özelliklerini birbirinden ayırmak gerekiyor. Azure Monitor Metrics, belirli performans verilerini zaman serisi olarak topluyor. CPU ve memory kullanımı, storage performansı, network throughput ve VM performansına ilişkin ölçümler bu kapsamda bulunuyor. Microsoft’un güncel dokümantasyonunda Azure Local için 60’tan fazla temel metrik sunulduğu belirtiliyor. Bu metrikler Azure Monitor Metrics Explorer üzerinden görüntülenebiliyor. Ancak Metrics tek başına bütün troubleshooting ihtiyaçlarını karşılamıyor. Örneğin storage latency değerinin yükseldiğini görebilirsiniz. Ama bunun nedenini anlamak için başka verilere ihtiyaç duyabilirsiniz. Bu noktada Insights devreye giriyor. Azure Local Insights, Azure Monitor Agent üzerinden toplanan performans ve sağlık verilerini Log Analytics Workspace içerisinde saklayabiliyor. Bu veriler Kusto Query Language, yani KQL kullanılarak sorgulanabiliyor. Insights ayrıca hazır workbook’lar üzerinden node, VM ve storage performansının görüntülenmesini sağlıyor. Örneğin bir Azure Local cluster’da belirli saatlerde storage latency yükseliyor olabilir. Metrics üzerinden bu artışı görebilirsiniz. Insights üzerinden ise ilgili zaman aralığındaki diğer performans verilerini beraber değerlendirebilirsiniz. Bence burada en önemli konu yalnızca anlık değerleri görmek değil. Normal çalışma davranışını bilmek. Çünkü bir storage sisteminde 5 ms latency her zaman problem anlamına gelmeyebilir. Başka bir uygulama için ise aynı değer önemli olabilir. Dolayısıyla monitoring sistemini kurduktan sonra belirli bir baseline oluşturmak gerekiyor.
Normal çalışma saatlerinde CPU kullanımı ne kadar?
Storage latency hangi aralıkta?
Network throughput ne seviyede?
Backup sırasında performans nasıl değişiyor?
Node maintenance sırasında sistem nasıl davranıyor?
Bunları bilmeden yalnızca belirli eşik değerleri üzerinden alarm oluşturmak yeterli değil.
Health Alerts ve merkezi alarm yönetimi
Azure Local üzerinde Health Service tarafından üretilen sağlık olayları da önemli. Microsoft, Azure Local monitoring mimarisinde 80’den fazla sağlık durumunun izlenebildiğini belirtiyor. Bunlar arasında fiziksel disk problemleri, network adapter sorunları, storage kapasitesi, cluster konfigürasyonu ve kaynak kullanımı gibi farklı durumlar bulunuyor. Health alert’lerin önemli avantajlarından biri sistem tarafından oluşturulmaları. Her alarm için sıfırdan KQL sorgusu hazırlamak gerekmiyor. Ancak burada dikkat edilmesi gereken konu bütün alarmların aynı öncelikte olmaması. Örneğin bir node üzerindeki fiziksel disk arızası ile CPU kullanımının kısa süreli yükselmesi aynı operasyonel önceliğe sahip değil. Bu nedenle alarm yönetimini sadece e-posta gönderen bir sistem olarak düşünmemek gerekiyor. Ben production ortamında alarmları operasyonel etkiye göre sınıflandırmayı tercih ederim. Örneğin storage resiliency kaybı veya kritik disk arızası doğrudan müdahale gerektirebilir. Buna karşılık belirli bir süre boyunca yüksek CPU kullanımı kapasite değerlendirmesi gerektirebilir. Azure Monitor üzerinden metric-based ve log-based alert kuralları oluşturulabiliyor. Ayrıca Microsoft belirli yaygın metrikler için recommended alert rule seçenekleri sunuyor. Ancak hazır alarm kurallarını doğrudan production ortamına uygulamak yerine kurumun workload davranışına göre değerlendirmek gerekiyor. Aksi halde gereğinden fazla alarm üretilebilir. Bu da bir süre sonra gerçek kritik alarmların gözden kaçmasına neden olabilir.
Troubleshooting sırasında nereden başlamalı?
Azure Local troubleshooting tarafında bence en önemli konu problemi doğru katmanda aramak. Örneğin bir sanal makinenin performansının düştüğünü düşünelim. İlk olarak VM içerisindeki işletim sistemini kontrol etmek doğal. Ancak sorun her zaman guest işletim sisteminde olmayabilir. VM’nin çalıştığı node üzerinde CPU veya memory baskısı olabilir. Storage Spaces Direct tarafında latency yükselmiş olabilir. Network ATC konfigürasyonunda problem oluşmuş olabilir. Fiziksel network adapter üzerinde hata bulunabilir. Ya da VM’nin Azure üzerinden yönetilmesiyle ilgili bir control plane problemi yaşanıyor olabilir. Bu nedenle troubleshooting sırasında önce problemin kapsamını belirlemek gerekiyor.
Sadece bir VM mi etkileniyor?
Aynı node üzerindeki bütün VM’ler mi etkileniyor?
Cluster genelinde mi problem var?
Azure portal üzerinden yönetim işlemleri mi başarısız oluyor?
Yoksa workload çalışmaya devam ederken yalnızca Azure bağlantısı mı problemli?
Bu ayrım oldukça önemli.
Örneğin Azure Arc Resource Bridge erişilemez hale geldiğinde Azure üzerinden VM lifecycle işlemleri etkilenebilir. Ancak bu durum çalışan bütün VM’lerin otomatik olarak duracağı anlamına gelmiyor. Benzer şekilde Azure portal üzerinde bir monitoring verisinin görüntülenememesi, fiziksel cluster’ın çalışmadığını göstermiyor. Bence Azure Local troubleshooting sürecinde en fazla zaman kazandıran yaklaşım problemi ilk aşamada doğru katmana ayırmak.
Update başarısız olduğunda ne yapılmalı?
Azure Local üzerinde update başarısız olduğunda ilk refleks node’ları manuel güncellemeye çalışmak olmamalı. Çünkü update orchestrator belirli bir aşamada hata almış olabilir. Örneğin update paketi başarıyla indirilmiş ancak health check başarısız olmuş olabilir. Başka bir senaryoda health check başarılıdır ancak SBE paketiyle ilgili problem yaşanmıştır. Ya da Cluster-Aware Updating sırasında bir node beklenen şekilde yeniden cluster’a katılamamıştır. Bu senaryoların çözümü aynı değil. Microsoft, update troubleshooting için Azure Update Manager üzerinden update history ve progress bilgilerinin incelenmesini öneriyor.
PowerShell tarafında ise Get-SolutionUpdate ve Get-SolutionUpdateRun komutları kullanılabiliyor.
Get-SolutionUpdate, update kaynaklarının ve durumlarının görüntülenmesini sağlıyor. Get-SolutionUpdateRun ise ilgili güncelleme çalışmasının ayrıntılarını incelemek için kullanılıyor.
Burada özellikle UpdateRun nesnesinin Progress bilgisi önemli. Çünkü güncellemenin hangi aşamada başarısız olduğunu gösterebiliyor.
Örneğin sorun download aşamasında mı?
Validation aşamasında mı?
Health check sırasında mı?
Yoksa installation action plan içerisinde mi?
Bu ayrımı yaptıktan sonra ilgili remediation adımlarını değerlendirmek gerekiyor. Microsoft’un update mekanizmasında retry ve remediation yetenekleri bulunuyor. Ancak bu özellikler bütün hataların otomatik olarak düzeltileceği anlamına gelmiyor. Bazı durumlarda administrator müdahalesi veya Microsoft Support desteği gerekebilir. Ben production ortamında başarısız update sonrasında rastgele servis restart işlemleri veya manuel paket kurulumu yapılmasını doğru bulmuyorum. Önce hata kaydı incelenmeli. Ardından Microsoft’un ilgili sürüm için önerdiği remediation uygulanmalı.
Get-SolutionHealthSummary ile sağlık kontrolleri
Azure Local 2610 sürümüyle gelen Get-SolutionHealthSummary komutu özellikle update troubleshooting tarafında kullanışlı. Bu komut en son solution health check sonuçlarının özetini görüntülemeyi sağlıyor. Özellikle kritik ve önemli sağlık problemlerinin daha hızlı belirlenmesine yardımcı oluyor. Örneğin bir update readiness kontrolü başarısız oldu. Azure portal üzerinde ilgili hata görüntüleniyor. Ancak daha ayrıntılı değerlendirme yapmak istiyorsunuz. 2610 ve üzerindeki desteklenen ortamlarda Get-SolutionHealthSummary komutuyla son sağlık kontrolünün sonuçlarını inceleyebilirsiniz. Burada dikkat edilmesi gereken konu komutun mevcut bütün sorunları otomatik olarak düzeltmemesi. Bu bir health summary mekanizması. Sorunun nedenini anlamaya yardımcı oluyor.
Ayrıca en son health check sonuçlarını gösterdiği için sistemde yeni bir değişiklik yapılmışsa ilgili doğrulamanın yeniden çalıştırılması gerekebilir. 2610 öncesindeki sürümlerde ise Get-SolutionUpdate nesnesinin HealthCheckResult bilgileri üzerinden benzer değerlendirmeler yapılabiliyor. Bu nedenle troubleshooting sırasında kullanılan Azure Local sürümünü bilmek önemli.
Yeni sürümde bulunan bir PowerShell komutunun eski sürümde de kullanılabileceğini varsaymamak gerekiyor.
Diagnostic log toplama
Azure Local troubleshooting tarafında önemli bir diğer konu diagnostic log toplama. Özellikle Microsoft Support ile çalışırken doğru logların toplanması problemin çözüm süresini doğrudan etkileyebiliyor. Microsoft, Azure Local üzerinde Telemetry and Diagnostics extension kullanıyor. Bu extension Azure portal içerisinde AzureEdgeTelemetryAndDiagnostics adıyla görüntülenebiliyor. Diagnostic loglar Azure portal üzerinden veya PowerShell kullanılarak toplanabiliyor.
PowerShell tarafında Send-DiagnosticData komutu kullanılıyor.
Bu komutla ilgili diagnostic bilgiler toplanabiliyor ve desteklenen seçeneklerle Microsoft’a gönderilebiliyor veya belirlenen bir lokasyona kaydedilebiliyor. Azure portal tarafında ise Azure Local instance içerisindeki Diagnostics and Remote Support bölümünden log toplama işlemi başlatılabiliyor. Burada önemli bir konu var. Diagnostic log toplama ile sürekli monitoring aynı şey değil.
Diagnostic loglar genellikle belirli bir problem araştırılırken toplanıyor. Örneğin update failure yaşandı. Microsoft Support belirli zaman aralığındaki logları istedi. Bu durumda ilgili zaman aralığına ait diagnostic bilgiler toplanabiliyor. Bence burada log toplama işleminin problem yaşandıktan çok uzun süre sonra yapılmaması önemli. Çünkü ilgili olayların hangi zaman aralığında gerçekleştiğini bilmek troubleshooting açısından değerli. Ayrıca logların hangi node üzerinde oluştuğu da önemli olabilir. Özellikle çok node’lu cluster ortamlarında bütün sistemden rastgele log toplamak yerine problemin kapsamına uygun diagnostic veri hazırlamak daha sağlıklı.
Observability çalışmıyorsa ne olacak?
Azure Local üzerinde troubleshooting sırasında karşılaşılabilecek başka bir senaryo da observability bileşenlerinin çalışmaması. Örneğin Azure Arc registration işlemi başarısız olmuş olabilir.
Ya da Telemetry and Diagnostics extension düzgün çalışmıyor olabilir. Bu durumda standart diagnostic log toplama mekanizmasını kullanamayabilirsiniz. Microsoft bu tür durumlar için standalone log collection yöntemini destekliyor. Bu modelde diagnostic veriler lokal olarak toplanabiliyor ve uygun koşullarda Microsoft’a gönderilebiliyor. Özellikle deployment veya registration sırasında problem yaşayan sistemlerde bu yöntem önemli. Çünkü Azure bağlantısı kurulamadığı için log toplayamamak troubleshooting sürecini tamamen durdurmamalı.
Microsoft’un güncel dokümantasyonunda bu senaryolar için Send-AzStackHciDiagnosticData komutu bulunuyor.
Ancak burada dikkat edilmesi gereken konu standalone log collection ile normal Send-DiagnosticData yönteminin farklı gereksinimlere sahip olması. Hangi yöntemin kullanılacağı sistemin registration, connectivity ve observability durumuna göre belirlenmeli. Bence Azure Local operasyon ekiplerinin bu iki yöntemi önceden bilmesi önemli. Çünkü problem yaşandığında hangi logun nereden toplanacağını araştırmak zaman kaybettirebilir.
Disconnected Azure Local ortamlarında operasyon
Önceki makalelerimizde Azure Local Disconnected Operations mimarisini detaylı olarak incelemiştik. Bu modelde update ve monitoring süreçleri de farklı değerlendirilmeli. Çünkü connected Azure Local ortamında kullanılan Azure Update Manager ve Azure Monitor servislerine erişim modeli disconnected deployment ile aynı değil. Dolayısıyla disconnected ortamda bütün güncelleme ve observability işlemlerinin public Azure üzerinden gerçekleştirileceğini varsaymak doğru değil. Özellikle güncelleme paketlerinin nasıl temin edileceği, hangi lokal yönetim bileşenlerinin kullanılacağı ve diagnostic bilgilerin nerede tutulacağı deployment mimarisine göre belirlenmeli. Burada önemli bir ayrım var.
Limited connectivity ile tamamen disconnected deployment aynı şey değil.
Microsoft, sınırlı bağlantıya sahip desteklenen Azure Local ortamlarında update paketlerinin manuel olarak indirilmesi, import edilmesi ve PowerShell üzerinden keşfedilmesi için yöntemler sunuyor. Ancak bu yöntemin bütün disconnected deployment modellerine aynı şekilde uygulanabileceğini düşünmemek gerekiyor. Tamamen disconnected mimaride ilgili deployment modelinin desteklediği lifecycle ve monitoring prosedürleri esas alınmalı. Bence özellikle kritik altyapılarda bu konu deployment öncesinde netleştirilmeli. Çünkü internet bağlantısı bulunmayan bir ortamda güncelleme paketinin nasıl getirileceği, doğrulanacağı ve uygulanacağı operasyonel olarak önemli. Aynı şekilde diagnostic logların dışarıya aktarılması kurumun güvenlik ve veri egemenliği politikalarıyla uyumlu olmalı.
Production ortamında nasıl bir operasyon modeli kurardım?
Ben Azure Local üzerinde production bir ortam yönetecek olsam update ve monitoring süreçlerini birbirinden ayrı ekiplerin bağımsız yürüttüğü işlemler olarak tasarlamazdım.
Öncelikle düzenli bir platform health kontrolü oluştururdum.
Cluster health.
Storage kapasitesi.
Disk ve network adapter durumu.
Node kaynak kullanımı.
Azure Arc bağlantısı.
Update readiness.
Bunları merkezi monitoring üzerinden takip ederdim.
Ardından güncelleme takvimini oluştururdum.
Yeni Azure Local sürümü yayımlandığında önce release notes ve known issues bilgilerini incelerdim.
Donanım üreticisinin ilgili sürümü doğrulayıp doğrulamadığını kontrol ederdim.
SBE gereksinimlerini değerlendirirdim.
Sonrasında mümkünse test ortamında güncellemeyi doğrulardım.
Production güncellemesi öncesinde ise mevcut cluster health durumunu kontrol ederdim.
Özellikle storage repair veya rebalance işlemleri devam ediyorsa bunların etkisini değerlendirirdim.
Cluster’ın bir node eksik çalışabilecek kapasiteye sahip olduğundan emin olurdum.
Kritik VM’lerin backup durumunu kontrol ederdim.
Burada önemli bir ayrıntı var.
Azure Local Solution Update mekanizması backup sisteminin alternatifi değil.
Güncelleme sırasında sorun yaşanması ihtimaline karşı kritik workload’ların recovery planı hazır olmalı.
Ardından Prepare Updates özelliğini kullanarak mümkün olan hazırlıkları maintenance window öncesinde tamamlardım.
Güncelleme sırasında Azure Update Manager üzerinden ilerlemeyi takip ederdim.
İşlem tamamlandıktan sonra yalnızca update status değerinin başarılı olmasına bakmazdım.
Cluster health durumunu yeniden kontrol ederdim.
Bütün node’ların beklenen durumda olduğunu doğrulardım.
Storage Spaces Direct sağlık durumunu incelerdim.
VM’lerin çalıştığını kontrol ederdim.
Kritik uygulamalar için uygulama ekiplerinden doğrulama alırdım.
Monitoring sistemindeki metrikleri güncelleme öncesindeki baseline ile karşılaştırırdım.
Örneğin güncelleme öncesinde storage latency ortalama 2 ms seviyesindeyken güncelleme sonrasında sürekli 15 ms seviyesine yükselmişse update başarılı görünse bile ayrıca araştırma yapmak gerekir.
Benzer şekilde network throughput değerlerinde veya CPU kullanımında beklenmeyen değişiklikler varsa bunların nedeni incelenmeli.
Çünkü başarılı update işlemi ile sağlıklı production operasyonu aynı şey değil.
Çok lokasyonlu Azure Local ortamlarında lifecycle yönetimi
Azure Local’ın dağıtık altyapı yaklaşımı özellikle çok lokasyonlu kurumlarda anlam kazanıyor. Örneğin 20 farklı üretim tesisinde Azure Local bulunduğunu düşünelim. Her tesiste farklı uygulamalar çalışıyor. Ancak bütün sistemlerin lifecycle yönetimi merkezi ekip tarafından gerçekleştiriliyor. Bu durumda her cluster’a ayrı ayrı bağlanıp update kontrolü yapmak operasyonel olarak zorlaşabilir. Azure Update Manager sayesinde birden fazla Azure Local instance’ın güncelleme durumu merkezi olarak görüntülenebiliyor.
Hangi lokasyonda hangi sürüm çalışıyor?
Hangi sistemde güncelleme bekliyor?
Hangi cluster readiness kontrolünden geçemiyor?
Hangi update işlemi başarısız olmuş?
Bu bilgiler merkezi olarak değerlendirilebiliyor. Ancak burada bütün lokasyonların aynı anda güncellenmesini önermem. Özellikle kritik üretim ortamlarında kademeli bir rollout yaklaşımı daha doğru. Önce test veya düşük kritik seviyedeki bir lokasyon. Ardından sınırlı sayıda production lokasyonu. Sonrasında diğer sistemler.
Bu yaklaşım sayesinde belirli bir sürümün kurumun kullandığı uygulamalarla veya donanım kombinasyonuyla beklenmeyen bir problemi varsa bütün lokasyonlar etkilenmeden durum fark edilebilir.
Ayrıca her lokasyonun bakım penceresi farklı olabilir.
Örneğin 7/24 çalışan üretim tesisleriyle hafta sonu kapalı olan ofislerin maintenance planı aynı olmayabilir.
Dolayısıyla merkezi yönetim bütün sistemleri aynı anda güncellemek anlamına gelmiyor.
Bence asıl avantaj, farklı lokasyonlarda aynı operasyon standardını uygulayabilmek.
Azure Local’da sağlıklı operasyonun karşılığı
Azure Local’ın update ve observability mimarisini değerlendirirken benim için en önemli konu, platformun kurulumu tamamlandıktan sonra nasıl işletileceği.
Çünkü bir Azure Local cluster kurmak projenin yalnızca başlangıcı.
Asıl operasyon bundan sonra başlıyor.
Yeni sürümler yayımlanacak.
Güvenlik güncellemeleri gelecek.
Firmware ve driver değişiklikleri yapılacak.
Diskler arızalanabilecek.
Storage kapasitesi artacak.
Yeni sanal makineler oluşturulacak.
Uygulama ekiplerinin performans beklentileri değişecek.
Bütün bunların yönetilebilir olması gerekiyor.
Microsoft’un Azure Local üzerinde Solution Update, Azure Update Manager, Azure Monitor ve Diagnostics bileşenlerini beraber sunmasının temel karşılığı da burada.
Ancak bu araçların bulunması tek başına sağlıklı operasyon anlamına gelmiyor.
Doğru update takvimi oluşturulmalı.
Donanım üreticisinin validation süreci takip edilmeli.
Health check sonuçları dikkate alınmalı.
Monitoring için normal çalışma baseline’ı belirlenmeli.
Diagnostic log toplama prosedürleri hazırlanmalı.
Backup ve recovery süreçleri test edilmeli.
Ve en önemlisi bütün bunlar kurumun change management sürecine dahil edilmeli.
Bence Azure Local’ın klasik sanallaştırma platformlarından ayrıldığı önemli noktalardan biri, altyapının yaşam döngüsünü daha bütünleşik bir modelle yönetmeye çalışması.
Ancak bu modelin başarılı olabilmesi için platformun desteklenen yöntemlerle işletilmesi gerekiyor.
Azure Local üzerinde güncelleme yapmak yalnızca yeni sürümü kurmak değil. Güncelleme öncesinde sağlıklı olan altyapının, işlem tamamlandıktan sonra da aynı güvenilirlikle çalıştığını doğrulamak.
Bu nedenle ben Azure Local operasyonlarında Update Lifecycle, Observability ve Troubleshooting konularını aynı sürecin parçaları olarak değerlendiriyorum.
Çünkü güncelleme sırasında ne olduğunu göremediğiniz, problem yaşandığında doğru logları toplayamadığınız ve sistemin normal performansını bilmediğiniz bir altyapıyı uzun vadede sağlıklı yönetmek zor.
Bir sonraki makalede ise mevcut sanallaştırma altyapılarından Azure Local’a geçiş konusunu inceleyeceğim.
VMware ve Hyper-V’den Azure Local’a Migration Factory başlığı altında Azure Migrate mimarisini, VM discovery ve assessment süreçlerini, replication ve migration aşamalarını, uygulama bağımlılıklarını ve özellikle büyük ölçekli migration projelerinde karşılaşılan operasyonel problemleri ele alacağız.
Çünkü Azure Local’ı doğru kurmak kadar, mevcut workload’ları bu platforma kontrollü şekilde taşımak da önemli.